英伟达连跌6周,市值蒸发10万亿人民币以上!
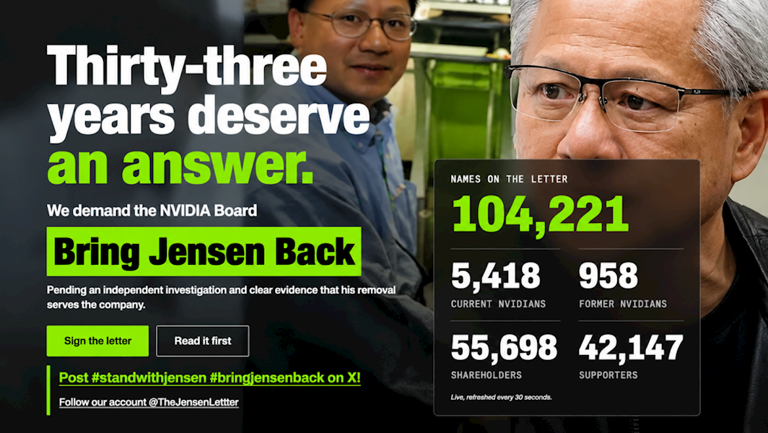
才过个周末就反转?马斯克及近10万人请愿恢复老黄CEO职位(这个数字还在增加,奔着20万以上去了),老黄也在硅谷同盟的帮助下考虑重回英伟达。
英伟达(NVDA.O)连跌六周,市值蒸发超10万亿元人民币。可国产算力芯片板块跌得也挺狠,寒武纪(688256.SH)、摩尔线程(688795.SH)都大幅下跌。明明利好国产算力,为什么跟跌?谁能跑出来?
01
利好国产的剧本,为什么演成了普跌?
很多人把原因归结为情绪悲观和交易拥挤。这没说错,但更真实的机制,是“β先杀、α紧随其后”。
先说一个容易被忽略的角度:英伟达过去其实是国产算力的隐性参照系。海外龙头站得高,国产算力公司才能顺着“替代空间大”拿到高定价。现在参照系自己晃了,资金只能回到A股内部逐项重审:利润率、研发投入、存货质量。定价中枢被动下移,基本面没变,参照系变了。
通俗点理解:全球的AI资产像一杆秤,英伟达是左边的秤砣。它的市值和业绩,证明了AI是条超级赛道,A股AI硬件的估值,是按照公司以后能在这条路上赚多少钱、占多大份额来计算。可现在秤的左边轻了,右边的东西自然就往下沉。
预期交易层面:国产算力在交易中仍被装在“高波动AI资产”的篮子里。它的中长期逻辑是自主可控,理论上和海外开支不同频。但海外算力锚一剧烈波动,资金的第一反应是先降仓位,再分辨逻辑。10月就有先例:国庆后6个交易日,核心算力芯片、服务器、存储跌幅普遍超过15%,反映的是筹码,不是基本面。
叙事层面:市场嘴上说国产算力是独立叙事,潜意识里仍在用两个海外变量定价:全球AI总需求是否继续扩张,海外头部平台是否还愿意砸钱。四大云厂商明年要投7000亿美元,超过全年云收入的总和;Meta(META.O)和亚马逊(AMZN.O)现金流转负,靠发债续命;算力租赁的信用利差一个月翻了近两倍。开支预期一收缩,国产链哪怕方向受益,也先被按“产业景气下修”处理。
国产算力正从“讲故事”切换到“讲兑现”,而兑现天然不平滑。最容易被误读:英伟达受限,订单不会平均分给所有国产厂商,只会更集中地流向少数能交付、能适配、能稳定运行的头部。市场一旦预期订单集中化,就会先卖掉“替代逻辑泛化”的中尾部标的,板块情绪随之承压。所以这轮普跌,本质是内部洗牌:从板块普涨,走向龙头溢价。
需求侧不用怀疑。有产业链口径显示,国内AI芯片2026年真实需求约420万颗,而中芯国际(688981.SH)7nm等效产线全年有效供给只有260万到300万颗,刚性缺口约四成。训练芯片从2026年四季度开始逐步交付,全年交付量集中在Q4释放。需求很旺,但季度之间的收入和利润,会被HBM、先进制程、封装、散热、整机验收反复拉扯。
有意思的是,市场最爱讨论HBM和制程,但多家产业链访谈给出的结论是:当前供应链的第一约束,是散热材料。单卡和机柜功耗持续抬升,散热不再是服务器配套,而是算力能否稳定释放的先决条件。高端TIM材料的认证周期长达1到3年。芯片设计成功,不等于系统爬坡成功。这让国产算力的收入确认,带上了更强的工程项目属性。
竞争维度也在变。过去拼单卡算力参数,现在拼的是高带宽互联、液冷供电、调度系统,最后落到单位Token成本。是卖卡,还是卖整柜和集群?是纸面TFLOPS高,还是Token产出效率高?答案决定客户给不给生产环境的订单。
还有一个藏在资产负债表里的信号。两家公司的存货和预付款都在飙升:
寒武纪的存货从25Q4的49亿元升到26Q3的117亿元;
摩尔线程从13亿元升到34亿元,预付款也抬到约26亿元。
这是把未来需求提前固化成供给。但它也宣告了一件事:这类公司已经不是轻资产主题股,而是重资产制造业。股价从此跟产能、交付、良率、存货走,波动自然更像制造业,而不是概念。
02
寒武纪赢在兑现,摩尔线程胜在平台
先看寒武纪。它走的是ASIC,AI专用芯片路线,最新产品思元690采用双die设计,FP16算力超700TFLOPS,配196GB HBM3。围绕AI计算做深度优化,有产业链口径称,寒武纪和华为的算子优化做得最好——算子优化不到位,芯片实际性能可能掉30%到50%。这是它在真实生产环境里的底牌。
兑现层面,它已经完成四重验证。收入:前三季度95.26亿元,同比增长106.76%。利润:归母净利润37.15亿元,Q3单季毛利率58.69%、净利率39.75%。订单:在手订单突破80亿元。备货:存货116.65亿元、预付款30.44亿元,另申请了120亿元授信额度用于HBM预付款,有产业链口径称拿下中芯北方约9%到11%的产能配额。客户也在核心链路上:字节跳动累计部署超十万张思元590/690;阿里巴巴(9988.HK)在测试思元690与自研处理器协同;腾讯控股(0700.HK)把思元590批量部署在微信视频号和腾讯云。这不是Demo订单,是已经沉淀成收入和利润的规模部署。
它的短板同样清楚。路线太专,图形渲染、物理仿真、通用计算都不占优;客户之前是用GPU的,换成ASIC,迁移要适配新生态,成本更高;生态上它已加入PyTorch基金会成为白金成员,主流大模型实现Day-0适配,但NeuWare/BANG路线对开发者的学习门槛更高;目前没有自建超节点,整机方案靠服务器厂商集成;客户集中和实体清单,是悬在头上的两件事。
再看摩尔线程。它选的是最难也最宽的路:全功能GPU。一颗芯片,同时覆盖AI训推、图形渲染、物理仿真、科学计算。旗舰产品S5000的FP8稠密算力达1000TFLOPS,配80GB显存,S6000和下一代架构已在推进。前三季度营收32.89亿元,同比增长319.15%,归母净利润3769.7万元,实现扭亏;其中Q3单季营收15.52亿元,归母净利润4926万元、扣非净利润2007万元,首次转正。刚跨过盈利拐点,绝对体量还小,但方向立住了。
它真正的杀手锏在生态。MUSA架构深度兼容CUDA,配套MUSIFY迁移工具做源码级转换,SGLang代码主线合入,TileLang-MUSA开源,开发者突破80万。客户的真实诉求不是完美自主,而是“今天就能把原有CUDA负载搬到国产平台”。这条路线刚好接住这个需求。但必须强调:能跑不等于跑得快,训练侧复杂算子、多卡通信仍需大量调优。兼容是入场券,不是终点线。
它的系统能力也领先一步。C128/C256超节点、KUAE智算集群、Scale-up全互联,加上与京东(9618.HK)京东云合作的十万卡全功能GPU集群,构成从芯片到集群再到模型工厂的完整闭环。还有一条独有的第二曲线:物理AI。MTLambda具身智能仿真平台已开源MuJoCo Warp MUSA,完成Sim2Real真机验证。这条线短期收入贡献不大,叙事稀缺性很强。
它的短板是路线本身。全功能GPU研发烧钱、设计复杂、驱动维护难度远高于专用芯片;兼容不自动带来性能优势;盈利刚过拐点,需要连续几个季度验证;十万卡集群若节奏不及预期,波动会比同行更大。
资本市场的剧本,正在从讲故事换成验货:
过去一年,国产算力按“替代叙事”定价,看故事、看催化、看海外映射。现在,定价标准换成了四样东西:能不能交付、有没有利润、能不能做集群、能不能锁定产能。谁只是“能做卡”,谁能“锁产能、做集群、跑模型、赚到钱”,市场开始分开对待。
寒武纪的叙事,更接近一个等待确定性修复的品种,风险偏好回暖时,大资金回补会先动它。摩尔线程的叙事,则是十万卡集群一旦有明确的采购和交付数据,MUSA在生产环境跑出更优的单位Token成本,它的定价框架就会升级。2026年8月,它已公告筹划发行H股,融资通道打开,扩张的弹药充足。一家买确定性,一家买可能性,这就是市场对两家公司的预期分化。
寒武纪和摩尔线程,谁能先跑出来?
结论给场景。只看短期,第一波修复大概率是寒武纪先动:利润、订单、产能锁定三项验证最全,市场不需要再等新故事。看到3到9个月,市场开始交易“谁更像平台”,摩尔线程的弹性更高。两家公司不是替代关系,是国产算力的两种定价模式。
风险也列清楚。第一,海外对远程获取高端算力的限制若继续升级,国产替代的斜率会被重新校准,两家同受影响;第二,交付集中在四季度,散热、封装、产能爬坡任何一环卡住,收入兑现就会后移,对摩尔线程冲击更直接;第三,寒武纪的客户集中与实体清单风险仍在;第四,摩尔线程的扣非盈利连续性和十万卡落地节奏,需要逐季验证。跟踪指标:存货和预付款、思元690与S5000的交付节奏、大厂扩单动向、扣非盈利的连续性。
你觉得老黄还能回到英伟达吗?